GPT‑6.1 Sol : les agents progressent, la preuve reste à lire
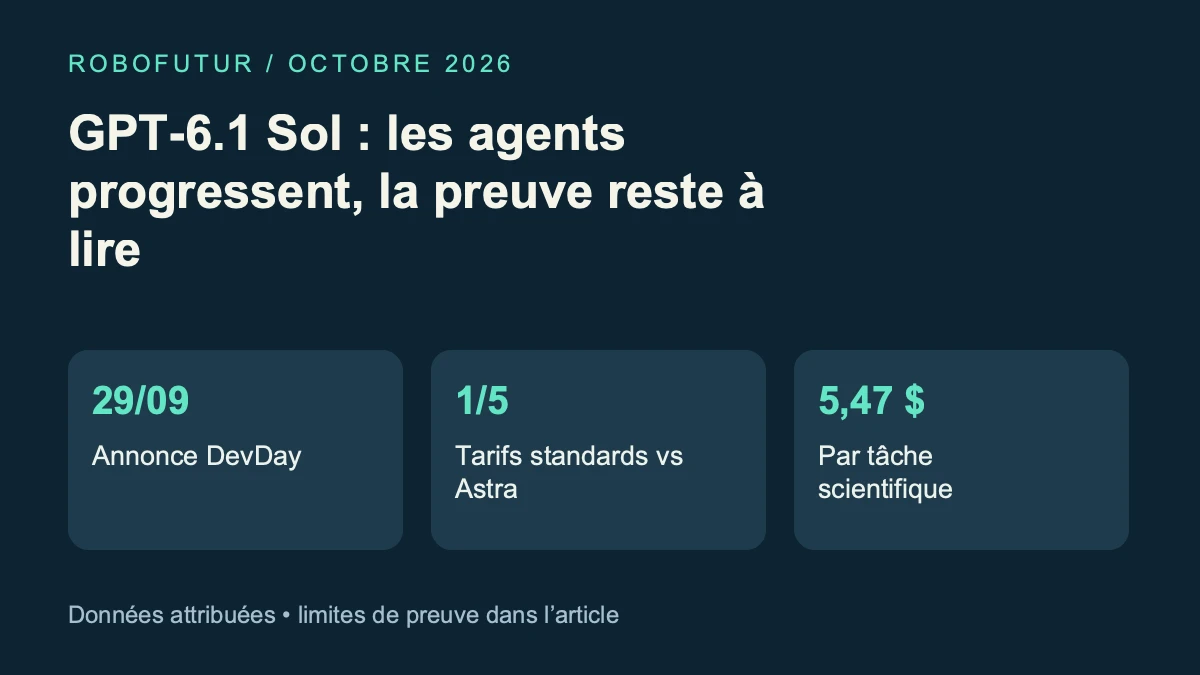
Le 29 septembre 2026, OpenAI a annoncé GPT‑6.1 Sol au DevDay. Le sujet intéresse la robotique par les outils logiciels qu’un agent peut utiliser ; il ne constitue pas une démonstration de commande d’un robot physique.
L’annonce et son périmètre
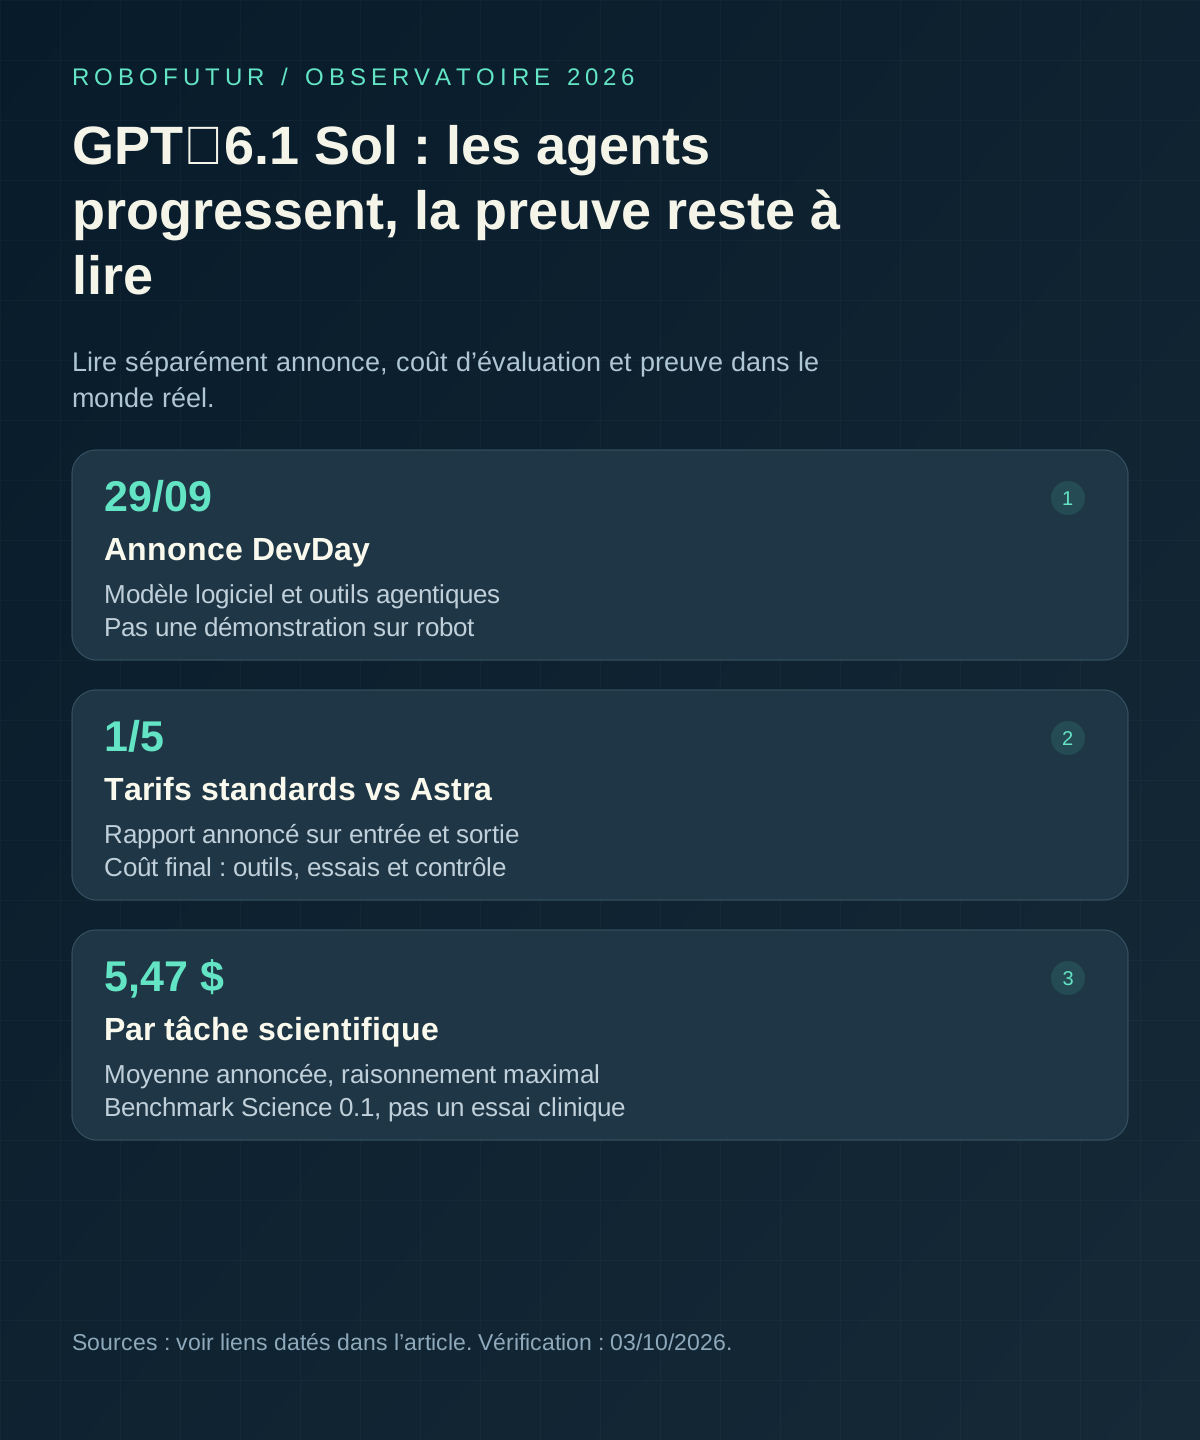
Le récapitulatif officiel annonce un meilleur modèle pour le code, l’utilisation d’un ordinateur et le travail professionnel. Il indique une disponibilité dans l’API et plusieurs offres ChatGPT. La page du modèle ajoute des évaluations de recherche scientifique. Selon OpenAI, les tarifs standards des jetons d’entrée et de sortie représentent un cinquième de ceux d’Astra ; ce rapport ne vaut pas pour toute facture réelle.
Sur Terminal-Bench Science 0.1, l’entreprise rapporte un coût moyen de 5,47 dollars par tâche pour Sol au niveau maximal de raisonnement, contre 23,80 pour Astra dans son évaluation. Astra garde le meilleur score du test, à 68,1 %. Ces valeurs décrivent un protocole d’évaluation donné.
Pourquoi un prix par jeton ne suffit pas
Notre lecture : le bon indicateur opérationnel est le coût d’une tâche correctement achevée. Il faut compter les tentatives, les appels aux outils, les échecs, les reprises et le temps de contrôle humain. Un modèle économique à la première requête peut devenir coûteux s’il doit recommencer plusieurs fois. À l’inverse, un modèle cher peut être pertinent sur une tâche rare dont l’erreur bloque toute une équipe.
Pour comparer deux agents, on peut préparer un petit ensemble de tâches représentatives et conserver les mêmes entrées, les mêmes outils et les mêmes critères de réussite. La question n’est pas de reproduire un classement mondial : elle est de savoir lequel fonctionne sur les dossiers du lecteur. Des PDF réels, des données incomplètes ou un outil qui répond mal donnent souvent une information plus utile qu’un exemple soigneusement choisi.
Recherche scientifique : le résultat doit rester inspectable
Un agent scientifique peut proposer une analyse convaincante sans que cette analyse réponde à la bonne question. La rédaction recommande donc de garder les données d’entrée, les scripts, les paramètres et le résultat intermédiaire. Une conclusion ne devient pas solide parce que le modèle cite un chiffre : on doit pouvoir retrouver comment le chiffre a été produit.
Pour un laboratoire, une première expérimentation raisonnable consiste à soumettre un résultat déjà connu et à vérifier si l’agent le retrouve avec les bons contrôles. Ce choix limite l’ambiguïté : si le résultat diverge, l’équipe peut chercher l’erreur dans les données, la méthode ou l’exécution. Le passage à une question nouvelle vient ensuite, avec une revue experte adaptée.
Ce que cela change pour les robots
Le développement robotique rassemble du code, de la simulation, des journaux d’erreurs et des interfaces. Un meilleur agent logiciel peut donc faciliter certaines étapes de préparation ou de diagnostic. Mais cela ne démontre ni une prise fiable sur un objet glissant, ni la stabilité d’un humanoïde, ni une cadence de production.
Notre dossier sur les mains robotiques montre pourquoi la matière impose d’autres contraintes. La capacité à écrire un programme et la capacité d’une machine à l’exécuter au contact du monde doivent être mesurées séparément. On attendrait des essais sur matériel, des conditions décrites et un bilan des échecs pour relier ce lancement logiciel à une avancée physique précise.
Comment lire la prochaine démonstration
Avant d’accepter une promesse de productivité, trois questions suffisent à cadrer la discussion : quelle tâche a été accomplie, quelle intervention humaine a été nécessaire et combien d’essais ont échoué ? Le coût est utile une fois ces réponses connues. Une vidéo réussie sans dénominateur ne permet pas de calculer une fiabilité.
Pour replacer cette annonce dans la semaine, voir les agents Dots, et notre explication des agents IA. Les annonces du DevDay sont un point de départ pour tester, pas une certification universelle.
✔ Comment nous avons vérifié
Sources primaires ouvertes et vérifiées le 3 octobre 2026. Les performances annoncées restent attribuées à leurs auteurs. Aucun test RoboFutur.
Informations vérifiées à la date de publication ou de mise à jour indiquée. La technologie évolue vite — consultez les sources ci-dessous.
Sources
- GPT-6.1 Sol — OpenAI
- DevDay 2026 Recap — 29 septembre — OpenAI